Kurzfassung: TypeSafe AIs Jev ist ein neues Modell im Early Access, das typisierte Fragen mit Auswahlwerten, Scores und Wahrscheinlichkeiten beantwortet, statt Prosa zu erzeugen.[1] TypeSafe berichtet in Workflow-Evaluationen bis zu 193,6-mal höhere Geschwindigkeit und 444,6-mal niedrigere Kosten. Das sind jedoch Anbieterwerte aus dem eigenen Testsystem, keine unabhängige Rangliste.[2] Der praktische Einsatz liegt bei schnellen Entscheidungen in Software: Routing, Risikoprüfungen, Wiederholungen und Übergaben an Menschen.
Die eigentliche Geschichte ist kein weiterer Chatbot-Start. TypeSafe AI setzt darauf, dass ein großer Teil der Arbeit, die heute an ein Sprachmodell geht, bereits eine Softwareentscheidung ist, die sich in einem Prompt versteckt.
Diese Wette stammt von Diogo Almeida, einem früheren OpenAI-Forscher. Gegenüber TechCrunch sagte er, die Optimierung auf menschliche Sprache habe die Automatisierung zurückgelassen.[5] Almeida gründete TypeSafe AI mit Erik Gafni und Sasha Sheng. Ihre provokante These: Chatmodelle wurden hervorragend darin, Menschen zufriedenzustellen, während Software Antworten braucht, die sich wie verlässliche Variablen verhalten.
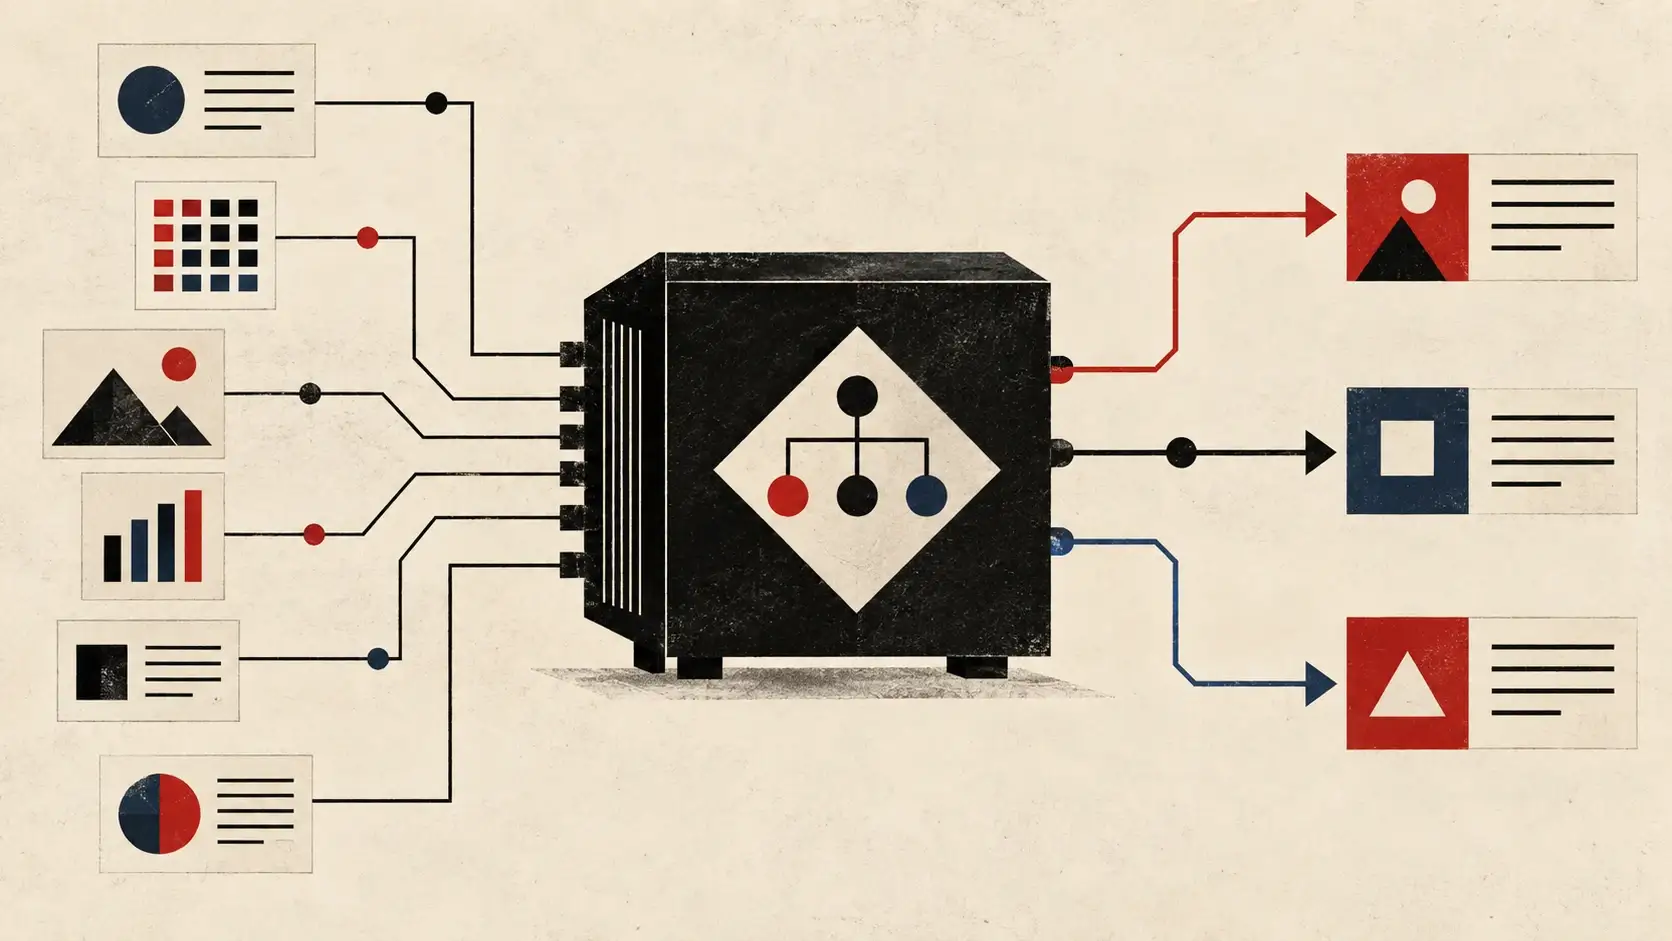
Jev ist der erste öffentliche Versuch, diese Kritik in ein Produkt zu verwandeln. Das Modell konkurriert nicht um den besten Essay oder das natürlichste Gespräch. Es erhält Anwendungszustand und typisierte Fragen und liefert begrenzte Antworten mit Wahrscheinlichkeitsverteilungen. „System One Models“ verweist auf Daniel Kahnemans schnelles, intuitives Denken. Der Name Jev erinnert an William Stanley Jevons und die Idee, dass billigere Intelligenz mehr Nachfrage erzeugt.[1]
Warum das gerade wichtig ist
Das Produkt: Intelligenz mit begrenzter Ausgabe
TypeSafe nennt Jev sein erstes „System One Model“, das für Entscheidungen gebaut wurde, die Software direkt verarbeiten kann.[1] Eine Frage kann ein Wahrheitswert, eine Auswahl aus einer festen Menge oder ein Score sein. Jev schreibt keine E-Mail, erfindet keinen Toolnamen und liefert keine abschließende Erklärung für Menschen. Genau diese Begrenzung ist das Produkt.
Die drei Grundtypen decken unterschiedliche Entscheidungen ab. Choice wählt aus einer von der Anwendung definierten Liste und liefert Wahrscheinlichkeiten für jede Option. Noul schätzt eine Ja-Nein-Aussage. Score ordnet eine Eingabe auf einer festgelegten Skala ein. Mehrere Fragen nutzen denselben Zustand, sodass eine Anfrage ein Ticket klassifizieren, Dringlichkeit einschätzen und Frustration bewerten kann.[6]
Das ist kein JSON-Modus unter neuem Namen. Ein Chatmodell erzeugt auch im JSON-Modus Tokens nacheinander und kann Reparaturen benötigen. Bei Jev ist der Antwortbereich vor der Inferenz definiert. Die Typgarantie verhindert fehlerhafte Felder. Sie garantiert keine richtige Entscheidung.
Was TypeSafe berichtet
Maximaler vom Anbieter berichteter Vorteil in der veröffentlichten Workflow-Evaluation.
Maximaler berichteter Kostenvorteil in derselben Evaluation.
Für das Modell typesafe/jev angegebene Tokenzahl.
Die Anwendungsfälle: Wo Entscheidungen Prosa schlagen
Erstens kann Jev Agenten routen. Aus dem aktuellen Zustand einer Aufgabe wählt es das nächste Tool oder den nächsten Subagenten aus einer Liste und liefert eine Konfidenz. Das Sprachmodell erledigt weiterhin die offene Arbeit; Jev wird zur schnellen Steuerung darum herum.
Zweitens geht es um Stoppen, Wiederholen oder Eskalieren. Ein Produktionsagent muss entscheiden, ob ein Toolfehler vorübergehend ist, ob Informationen fehlen oder ob eine Aktion sicher genug zum Fortfahren ist. Typisierte Antworten lassen sich leichter validieren als ein Absatz, in dem zufällig „wiederholen“ steht.
Drittens eignet sich der Ansatz für Triage. Supporttickets, Betrugswarnungen und Störungsmeldungen haben bekannte Zielwarteschlangen. Jev kann Dringlichkeit bewerten, eine Abteilung auswählen und Unsicherheit markieren, bevor ein Mensch oder ein größeres Modell übernimmt.
Viertens kann Jev Benutzeroberflächen steuern. Ein Browser- oder Spieleagent kann eine endliche Menge möglicher Aktionen anbieten und fragen, welche am besten zum aktuellen Bildschirmzustand passt. Das ist ein plausibleres Ziel für niedrige Latenz als ein allgemeines Modell, das jeden Schritt beschreiben soll.
Entwickler testen diese Kontrollschleife bereits. Ein öffentlicher Drohnensimulator lässt Jev Schub, Gieren, Nicken und Rollen auswählen, während normaler Code Höhe, Richtung und Hindernisse berechnet. Das Projekt berichtet Entscheidungen in ungefähr 200 Millisekunden und hält harte Sicherheitsgrenzen außerhalb des Modells.[7]
Bei Coding-Agenten kann ein Harness fragen, ob ein Testfehler durch die letzte Änderung entstand, ob ein weiterer Toolaufruf nötig ist, ob die Aufgabe abgeschlossen ist und welcher Spezialist übernehmen soll. Jev schreibt den Patch nicht. Es kann teure generative Aufrufe zur Koordination reduzieren.
Im Kundenbetrieb liegt der unmittelbarere Markt. Eine Anfrage kann ein Ticket routen, Abwanderungsrisiko erkennen, Dringlichkeit bestimmen und Stimmung bewerten. Fälle mit hoher Konfidenz laufen automatisch, unklare Fälle gehen an Menschen.
Die Ökonomie: Günstige Aufrufe verändern die Architektur
TypeSafes Website stellt einen Jev-Workflow mit 0,114 Sekunden und 0,000081 Dollar einem LLM-Workflow mit 8,566 Sekunden und 0,013880 Dollar gegenüber.[2] Das ist überzeugend, weil solche Aufrufe tausendfach wiederholt werden. Zugleich hängen die Werte von Workflow, Modellen, Hardware, Parallelität und Akzeptanzkriterien ab.
Glaubwürdig ist zunächst die Richtung: Teure generative Aufrufe bleiben für Aufgaben mit Sprache, während ein Entscheidungsmodell die wiederkehrenden Verzweigungen übernimmt. Das kann Latenz und Parsing-Code reduzieren, auch wenn das Gesamtsystem weiter ein Frontier-Modell benötigt.
Die frühe Nachfrage zeigt, dass Entwickler die Idee verstehen. Vercel sagt, Jev habe innerhalb von 24 Stunden fast 13 Prozent der zahlenden AI-Gateway-Teams erreicht, mehr als doppelt so viele wie jeder frühere Modellstart auf der Plattform.[4] Das ist ein plattformspezifisches Nutzungssignal, kein Beleg für Bindung oder Produktionswert.
Community-Dokumentation für die OpenRouter-Route nennt für Jev 1.13 0,042 Dollar pro Million Eingabetokens und keine Ausgabekosten. Der Zugriff läuft über einen eigenen Entscheidungsendpunkt statt über Chat Completions.[8] Damit wird der enge Vertrag technisch erzwungen.
Die Mechanik: Fragen werden zu einem Rechengraphen
Jev ist am nützlichsten, wenn ein Team die Entscheidungsfläche vor dem Prompt festlegt. Ein Support-Workflow kann urgent als Wahrheitswert, department als Auswahl aus vier Feldern und refund_score als numerischen Score definieren. Die Anwendung führt die Fragen parallel aus, validiert die Typen und wendet Schwellenwerte im normalen Code an. Eine Antwort mit geringer Konfidenz kann in eine Prüfschleife gehen.
Das verändert die Beobachtbarkeit. Statt eine lange Ausgabe zu protokollieren, kann ein Betreiber die Kalibrierung pro Frage messen: Wie oft war das 0,8-bis-0,9-Intervall tatsächlich dringend, wie oft wählte der Router die falsche Warteschlange, und wie viele Übergaben wurden vermieden? Die Evaluationseinheit wird das Feld, das eine Aktion steuert.
Der Einführungstest: Einen Zweig ersetzen und messen
Der sinnvolle erste Einsatz ist ein Shadow-Modus. Jev läuft neben der bisherigen Regel oder dem LLM, speichert Entscheidung und Konfidenz, lässt aber das alte System handeln. Nach einem festen Zeitraum werden Fehlalarme, übersehene Fälle, Prüfvolumen, Latenz und Kosten verglichen. Erst dann werden Fälle mit hoher Konfidenz freigeschaltet.
Hier werden Jevs Grenzen sichtbar. Unklare Kriterien erzeugen eine präzise wirkende Wahrscheinlichkeit, ohne den zugrunde liegenden Regelkonflikt zu lösen. Teams brauchen versionierte Kriterien, gelabelte Beispiele und ein Auditprotokoll für jede Schwellenwertänderung.
Die Architektur: Jev sitzt zwischen Wahrnehmung und Aktion
Jev ist allein kein autonomer Agent. Es braucht einen Zustandsaufbau, der sichtbare Fakten auswählt, ein Fragenschema mit legalen Ausgabewerten und eine Richtlinienschicht, die Konfidenz in Aktionen übersetzt. Wenn der Zustandsaufbau die letzte fehlgeschlagene Zahlung unterschlägt, kann Jev bei unvollständigen Daten perfekt kalibriert sein und trotzdem falsch routen.
Das robusteste Design hat drei Stufen. Ein größeres Modell oder ein deterministischer Parser baut den Zustand. Jev bewertet mehrere begrenzte Fragen parallel. Normaler Code setzt Berechtigungen, Schwellenwerte und Nebenwirkungen um. So bleibt Sprachgenerierung dort, wo sie nützt, während irreversible Aktionen hinter testbarem Code liegen.
Die Benchmarkfrage: Was bedeutet „Intelligenz“ hier?
TypeSafes Workflow-Evaluation vergleicht Jev mit größeren Modellen anhand eines Rechengraphen und meldet einen Pareto-Vorteil.[1] Das ist nur dann aussagekräftig, wenn der Graph die Produktionsentscheidung abbildet. Ein Benchmark kann passende Referenzwahrscheinlichkeiten belohnen und zugleich Zustandsaufbau, Wiederholungen, menschliche Prüfung und Schäden durch falsche Verzweigungen auslassen.
Teams sollten für jede wichtige Aktion eine Konfusionsmatrix veröffentlichen. Bei Betrug zählen falsche Freigaben und Ablehnungen, beim Support Fehlrouting und ungelöste Tickets, beim Agentensteuerwerkzeug unsichere Aufrufe und unnötige Eskalationen. Die nützliche Frage lautet nicht, ob Jev „ein LLM schlägt“, sondern ob der gesamte Workflow weniger teure Fehler macht.
TypeSafe verwendet bei einigen Workflows Wahrscheinlichkeiten großer externer Modelle als Referenzziele.[1] Das misst Übereinstimmung mit einem gewählten Referenzensemble, nicht direkte Wahrheit. „Gleiche Wahrscheinlichkeiten wie Astra und Fable“ beweist nicht, dass diese Wahrscheinlichkeiten richtig waren.
Die fehlende unabhängige Evidenz ist Kalibrierung in echten Domänen. Wenn Jev tausend Eskalationen mit 0,8 bewertet, sollten unter stabilen Regeln ungefähr achthundert wirklich eskalationswürdig sein. Dafür braucht es zurückgehaltene Produktionsdaten, klare Definitionen und genügend Beispiele in jedem Konfidenzbereich.
Die Wettbewerbsfrage: Neues Modell oder neue Schicht?
Jev wird kaum Modelle ersetzen, die Code schreiben, Forschung zusammenfassen oder mit Kunden sprechen. Die plausiblere Rolle liegt zwischen diesen Modellen und der Anwendung. Damit konkurriert TypeSafe gleichzeitig mit kleinen Klassifikatoren, Regelmaschinen, Rerankern, strukturierten Ausgaben allgemeiner Modelle und handgebautem Orchestrierungscode.
Regeln bleiben besser, wenn eine Bedingung stabil und explizit ist. Ein lokaler Klassifikator kann billiger sein, wenn genügend gelabelte Daten existieren. Ein Frontier-Modell bleibt besser, wenn der Antwortbereich offen ist. Jev gewinnt in der Mitte: wiederholte Entscheidungen mit semantischem Urteil, begrenztem Antwortbereich und nützlicher Unsicherheit.
Diese Mitte ist groß. Agentensysteme treffen um jede sichtbare Antwort Dutzende Routing-, Stopp- und Prüfentscheidungen. TypeSafe muss Jev nicht zum Modell machen, mit dem Nutzer sprechen. Es muss zum Modell werden, das Software vor einer Aktion befragt.
Die Grenze: Konfidenz ist keine Wahrheit
TypeSafe sagt, Jev könne keine Typfehler erzeugen, und beschreibt die Entscheidungen als kalibriert. Eine Wahrscheinlichkeit bleibt eine Modelleinschätzung. Teams müssen Schwellenwerte setzen, Ergebnisse protokollieren und Fehlalarme für jeden Workflow messen.
Die Cloudflare-Integration macht die Schnittstelle konkret: ein Zustand, mehrere typisierte Fragen und Konfidenzwerte für den Anwendungscode.[3] Das beweist weder die Eignung für jede Domäne noch, dass 0,99 Konfidenz bei Support, Sicherheit und Finanzen dasselbe bedeutet.
Was nicht bewiesen ist
Let's be clear: Jev ist interessant, weil es eine Prosa-Schicht aus Entscheidungen entfernt, die Software ohnehin treffen muss. Wenn TypeSafe die Wahrscheinlichkeiten ehrlich und den Dienst zuverlässig hält, kann Jev zur Infrastruktur rund um Agenten werden.
Sources & References
Key sources and references used in this article
| # | Source | Outlet | Date | Key Takeaway |
|---|---|---|---|---|
| 1 | TypeSafe AI | 14. September 2026 | Modellthese, Trainingsansatz und Benchmarkangaben. | |
| 2 | TypeSafe AI | Abgerufen am 19. September 2026 | Geschwindigkeits-, Kosten- und Positionierungsangaben. | |
| 3 | Cloudflare | Abgerufen am 19. September 2026 | Dokumentation für typisierte Fragen und 32.000 Kontext-Tokens. | |
| 4 | Vercel | 18. September 2026 | Fast 13 Prozent der zahlenden Teams in 24 Stunden laut Vercel. | |
| 5 | TechCrunch | 18. September 2026 | Gründerhistorie und Almeidas Automationsthese. | |
| 6 | Pydantic | Abgerufen am 19. September 2026 | Unabhängige Integrationsdokumentation für typisierte Felder. | |
| 7 | GitHub | Abgerufen am 19. September 2026 | Drohnensimulator mit Code-Sicherheitsgrenzen und Jev-Entscheidungen. | |
| 8 | GitHub | Abgerufen am 19. September 2026 | OpenRouter-Endpunkt, Preis-Snapshot und testbare Richtlinienmuster. |
Zuletzt aktualisiert: 19. September 2026